ONLINE TERMINAL // LATENCY ULTRA LOW
求索未来 · 网页版入口
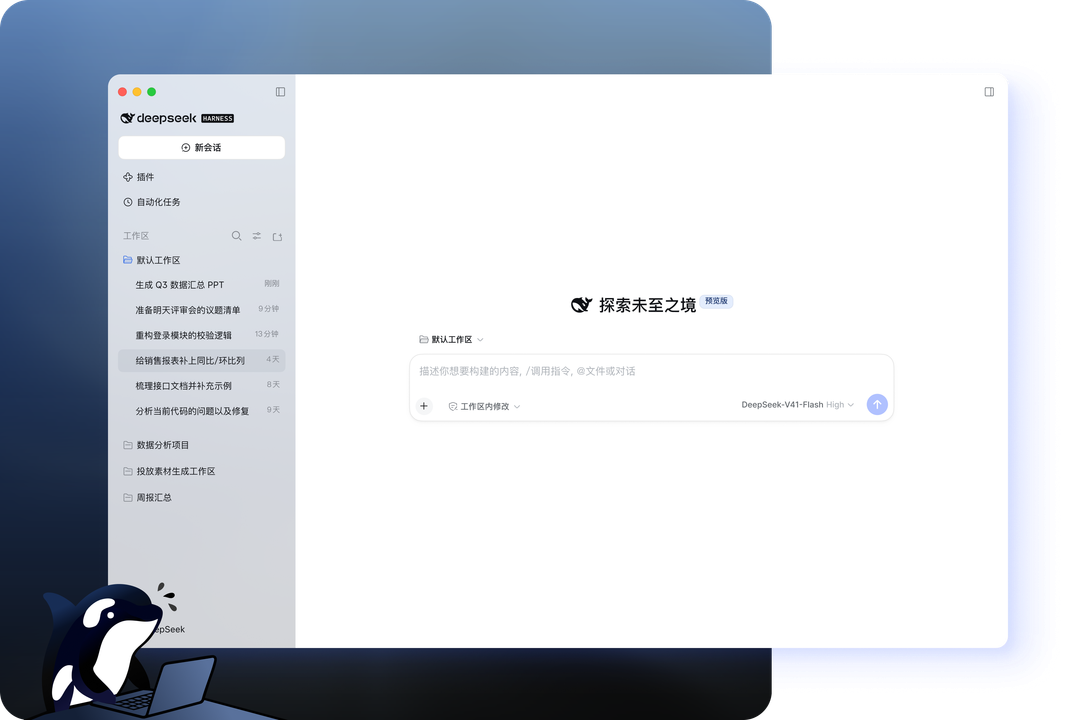
免配置、即开即用。欢迎进入 DeepSeek网页版 官方在线工作台。在此您可以直观观察 DeepSeek AI 的自发反思与分步检验链条,体验纯强化学习驱动的深层数理分析。
用户:请推导 DeepSeek MLA(多头潜在注意力机制)相较传统 MHA 在显存压缩上的本质优势?
▶ 深度思考链 (Reasoning Steps):
1. 明确 Multi-head Latent Attention (MLA) 的核心设计哲学:低秩键值联合压缩;
2. 分析推理阶段解耦旋转位置编码 (RoPE) 对 KV Cache 保留的决定性影响;
3. 计算显存占用下降倍率与吞吐提升数据。
DeepSeek AI 回答:1. 明确 Multi-head Latent Attention (MLA) 的核心设计哲学:低秩键值联合压缩;
2. 分析推理阶段解耦旋转位置编码 (RoPE) 对 KV Cache 保留的决定性影响;
3. 计算显存占用下降倍率与吞吐提升数据。
DeepSeek 提出的 MLA 机制,通过将 Key 与 Value 联合投影压缩至一个低维潜在向量(Latent Vector),使得在推理生成阶段只需缓存压缩后的潜在表征。相比传统 Multi-Head Attention (MHA),MLA 将 KV Cache 的显存开销降低了惊人的数倍,极大提升了超长上下文长文档分析与高并发场景下的生成吞吐。
长程稳定记忆流
最高支持 64K 上下文窗口,长篇文献推演与大型软件代码工程均能保持逻辑连贯。
算法级编程重构
覆盖现代主流编程语言,支持静态分析、复杂算法实现与自动化单元测试生成。
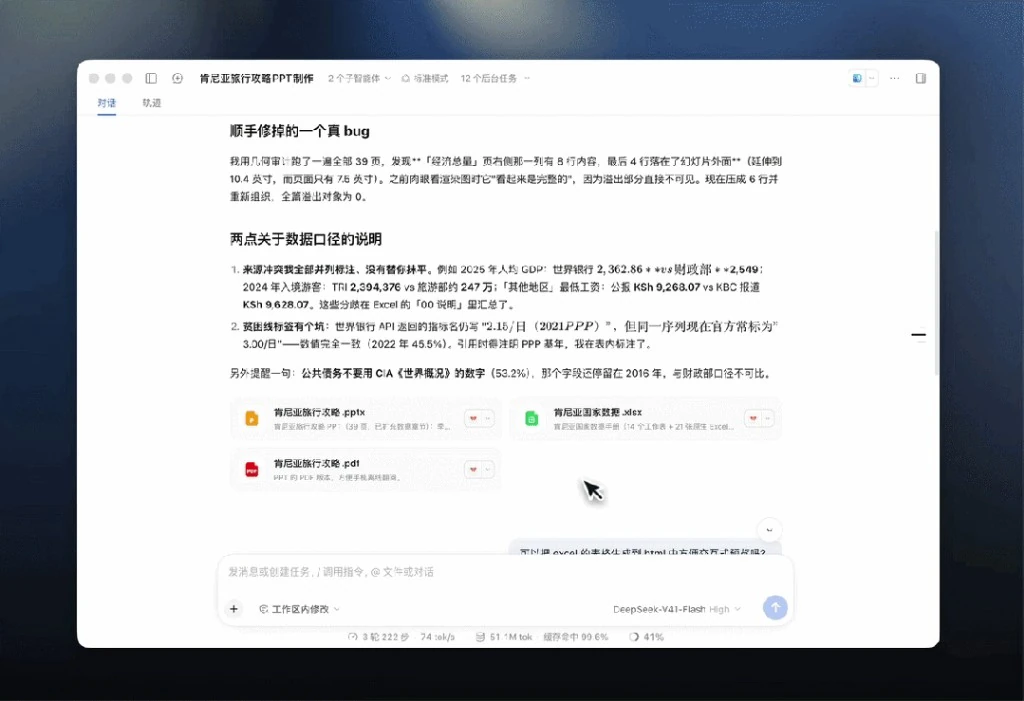
LaTeX 严密排版渲染
内置标准 LaTeX 解析引擎,将复杂微积分与群论方程以清晰优美的学术排版优雅呈现。
开箱即用零门槛
通过官方 DeepSeek网页版入口,免去本地环境搭建,随时随地开启对话。
全天候稳定服务
多地分布式冗余算力,保障即便在高峰时段也能提供毫秒级首字响应体验。
企业级隐私隔离
全程端到端加密传输,会话记录不落盘,不用于二次预训练,保障商业数据隐私。